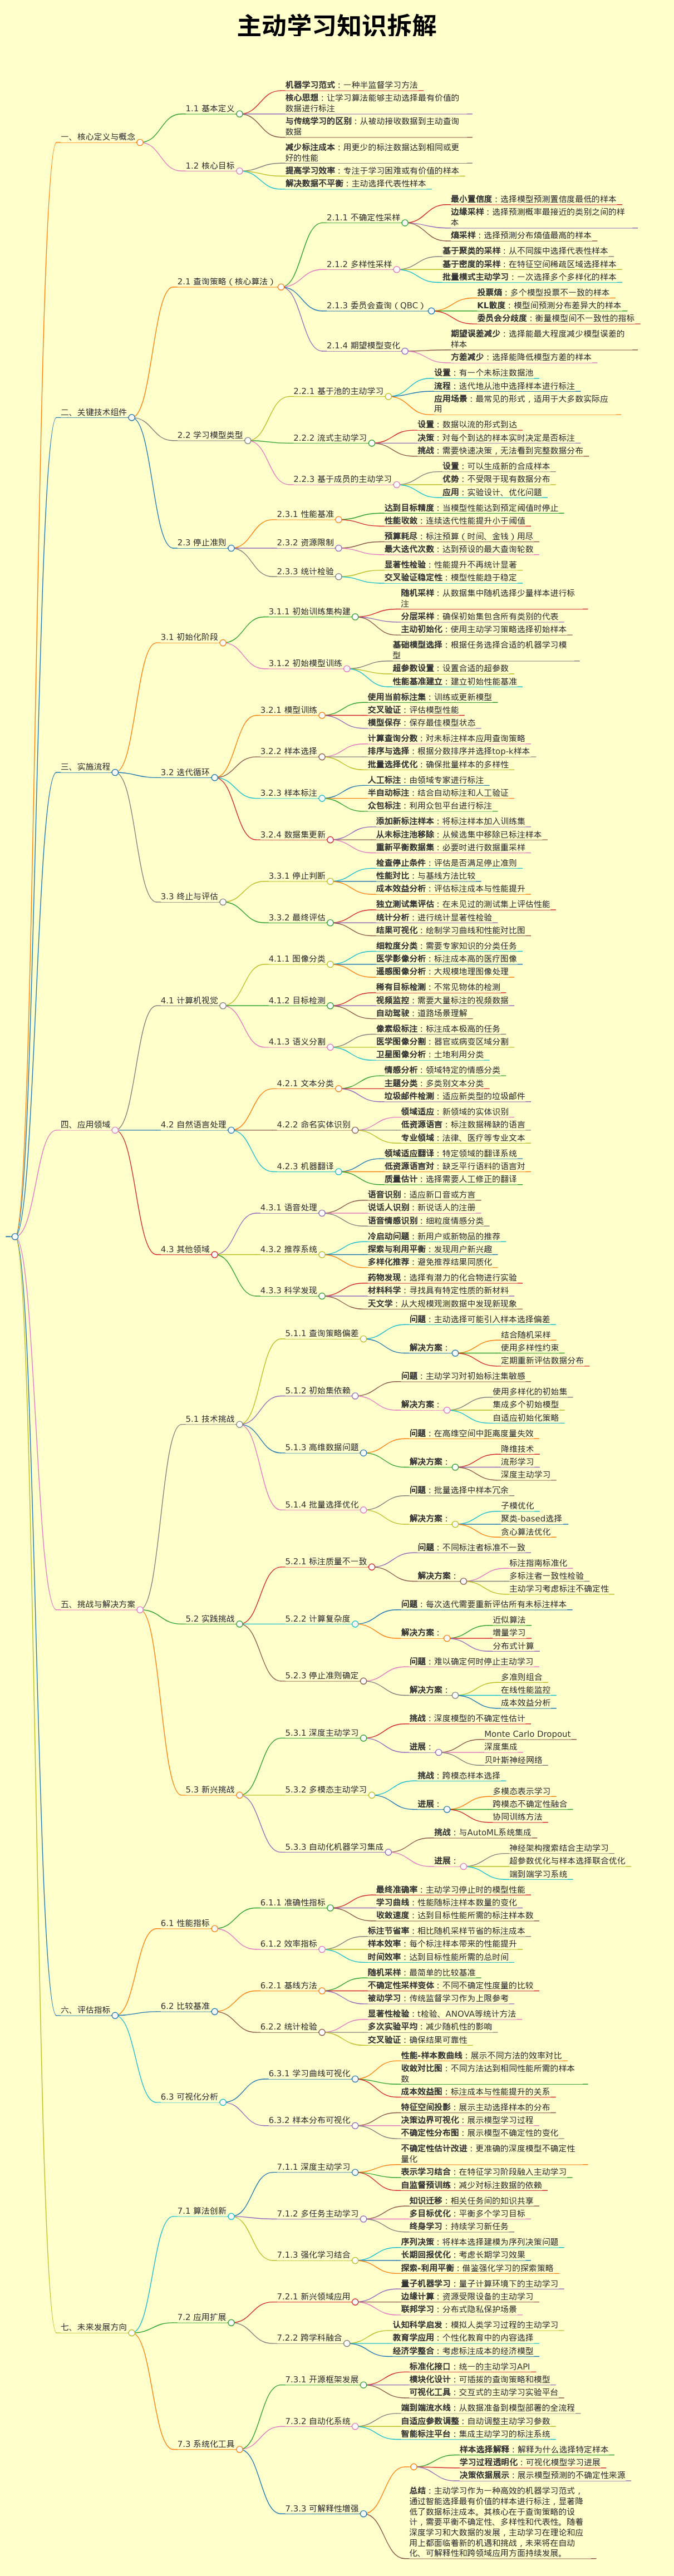
# 主动学习知识拆解
## 一、核心定义与概念
### 1.1 基本定义
- **机器学习范式**:一种半监督学习方法
- **核心思想**:让学习算法能够主动选择最有价值的数据进行标注
- **与传统学习的区别**:从被动接收数据到主动查询数据
### 1.2 核心目标
- **减少标注成本**:用更少的标注数据达到相同或更好的性能
- **提高学习效率**:专注于学习困难或有价值的样本
- **解决数据不平衡**:主动选择代表性样本
## 二、关键技术组件
### 2.1 查询策略(核心算法)
#### 2.1.1 不确定性采样
- **最小置信度**:选择模型预测置信度最低的样本
- **边缘采样**:选择预测概率最接近的类别之间的样本
- **熵采样**:选择预测分布熵值最高的样本
#### 2.1.2 多样性采样
- **基于聚类的采样**:从不同簇中选择代表性样本
- **基于密度的采样**:在特征空间稀疏区域选择样本
- **批量模式主动学习**:一次选择多个多样化的样本
#### 2.1.3 委员会查询(QBC)
- **投票熵**:多个模型投票不一致的样本
- **KL散度**:模型间预测分布差异大的样本
- **委员会分歧度**:衡量模型间不一致性的指标
#### 2.1.4 期望模型变化
- **期望误差减少**:选择能最大程度减少模型误差的样本
- **方差减少**:选择能降低模型方差的样本
### 2.2 学习模型类型
#### 2.2.1 基于池的主动学习
- **设置**:有一个未标注数据池
- **流程**:迭代地从池中选择样本进行标注
- **应用场景**:最常见的形式,适用于大多数实际应用
#### 2.2.2 流式主动学习
- **设置**:数据以流的形式到达
- **决策**:对每个到达的样本实时决定是否标注
- **挑战**:需要快速决策,无法看到完整数据分布
#### 2.2.3 基于成员的主动学习
- **设置**:可以生成新的合成样本
- **优势**:不受限于现有数据分布
- **应用**:实验设计、优化问题
### 2.3 停止准则
#### 2.3.1 性能基准
- **达到目标精度**:当模型性能达到预定阈值时停止
- **性能收敛**:连续迭代性能提升小于阈值
#### 2.3.2 资源限制
- **预算耗尽**:标注预算(时间、金钱)用尽
- **最大迭代次数**:达到预设的最大查询轮数
#### 2.3.3 统计检验
- **显著性检验**:性能提升不再统计显著
- **交叉验证稳定性**:模型性能趋于稳定
## 三、实施流程
### 3.1 初始化阶段
#### 3.1.1 初始训练集构建
- **随机采样**:从数据集中随机选择少量样本进行标注
- **分层采样**:确保初始集包含所有类别的代表
- **主动初始化**:使用主动学习策略选择初始样本
#### 3.1.2 初始模型训练
- **基础模型选择**:根据任务选择合适的机器学习模型
- **超参数设置**:设置合适的超参数
- **性能基准建立**:建立初始性能基准
### 3.2 迭代循环
#### 3.2.1 模型训练
- **使用当前标注集**:训练或更新模型
- **交叉验证**:评估模型性能
- **模型保存**:保存最佳模型状态
#### 3.2.2 样本选择
- **计算查询分数**:对未标注样本应用查询策略
- **排序与选择**:根据分数排序并选择top-k样本
- **批量选择优化**:确保批量样本的多样性
#### 3.2.3 样本标注
- **人工标注**:由领域专家进行标注
- **半自动标注**:结合自动标注和人工验证
- **众包标注**:利用众包平台进行标注
#### 3.2.4 数据集更新
- **添加新标注样本**:将标注样本加入训练集
- **从未标注池移除**:从候选集中移除已标注样本
- **重新平衡数据集**:必要时进行数据重采样
### 3.3 终止与评估
#### 3.3.1 停止判断
- **检查停止条件**:评估是否满足停止准则
- **性能对比**:与基线方法比较
- **成本效益分析**:评估标注成本与性能提升
#### 3.3.2 最终评估
- **独立测试集评估**:在未见过的测试集上评估性能
- **统计分析**:进行统计显著性检验
- **结果可视化**:绘制学习曲线和性能对比图
## 四、应用领域
### 4.1 计算机视觉
#### 4.1.1 图像分类
- **细粒度分类**:需要专家知识的分类任务
- **医学影像分析**:标注成本高的医疗图像
- **遥感图像分析**:大规模地理图像处理
#### 4.1.2 目标检测
- **稀有目标检测**:不常见物体的检测
- **视频监控**:需要大量标注的视频数据
- **自动驾驶**:道路场景理解
#### 4.1.3 语义分割
- **像素级标注**:标注成本极高的任务
- **医学图像分割**:器官或病变区域分割
- **卫星图像分析**:土地利用分类
### 4.2 自然语言处理
#### 4.2.1 文本分类
- **情感分析**:领域特定的情感分类
- **主题分类**:多类别文本分类
- **垃圾邮件检测**:适应新类型的垃圾邮件
#### 4.2.2 命名实体识别
- **领域适应**:新领域的实体识别
- **低资源语言**:标注数据稀缺的语言
- **专业领域**:法律、医疗等专业文本
#### 4.2.3 机器翻译
- **领域适应翻译**:特定领域的翻译系统
- **低资源语言对**:缺乏平行语料的语言对
- **质量估计**:选择需要人工修正的翻译
### 4.3 其他领域
#### 4.3.1 语音处理
- **语音识别**:适应新口音或方言
- **说话人识别**:新说话人的注册
- **语音情感识别**:细粒度情感分类
#### 4.3.2 推荐系统
- **冷启动问题**:新用户或新物品的推荐
- **探索与利用平衡**:发现用户新兴趣
- **多样化推荐**:避免推荐结果同质化
#### 4.3.3 科学发现
- **药物发现**:选择有潜力的化合物进行实验
- **材料科学**:寻找具有特定性质的新材料
- **天文学**:从大规模观测数据中发现新现象
## 五、挑战与解决方案
### 5.1 技术挑战
#### 5.1.1 查询策略偏差
- **问题**:主动选择可能引入样本选择偏差
- **解决方案**:
- 结合随机采样
- 使用多样性约束
- 定期重新评估数据分布
#### 5.1.2 初始集依赖
- **问题**:主动学习对初始标注集敏感
- **解决方案**:
- 使用多样化的初始集
- 集成多个初始模型
- 自适应初始化策略
#### 5.1.3 高维数据问题
- **问题**:在高维空间中距离度量失效
- **解决方案**:
- 降维技术
- 流形学习
- 深度主动学习
#### 5.1.4 批量选择优化
- **问题**:批量选择中样本冗余
- **解决方案**:
- 子模优化
- 聚类-based选择
- 贪心算法优化
### 5.2 实践挑战
#### 5.2.1 标注质量不一致
- **问题**:不同标注者标准不一致
- **解决方案**:
- 标注指南标准化
- 多标注者一致性检验
- 主动学习考虑标注不确定性
#### 5.2.2 计算复杂度
- **问题**:每次迭代需要重新评估所有未标注样本
- **解决方案**:
- 近似算法
- 增量学习
- 分布式计算
#### 5.2.3 停止准则确定
- **问题**:难以确定何时停止主动学习
- **解决方案**:
- 多准则组合
- 在线性能监控
- 成本效益分析
### 5.3 新兴挑战
#### 5.3.1 深度主动学习
- **挑战**:深度模型的不确定性估计
- **进展**:
- Monte Carlo Dropout
- 深度集成
- 贝叶斯神经网络
#### 5.3.2 多模态主动学习
- **挑战**:跨模态样本选择
- **进展**:
- 多模态表示学习
- 跨模态不确定性融合
- 协同训练方法
#### 5.3.3 自动化机器学习集成
- **挑战**:与AutoML系统集成
- **进展**:
- 神经架构搜索结合主动学习
- 超参数优化与样本选择联合优化
- 端到端学习系统
## 六、评估指标
### 6.1 性能指标
#### 6.1.1 准确性指标
- **最终准确率**:主动学习停止时的模型性能
- **学习曲线**:性能随标注样本数量的变化
- **收敛速度**:达到目标性能所需的标注样本数
#### 6.1.2 效率指标
- **标注节省率**:相比随机采样节省的标注成本
- **样本效率**:每个标注样本带来的性能提升
- **时间效率**:达到目标性能所需的总时间
### 6.2 比较基准
#### 6.2.1 基线方法
- **随机采样**:最简单的比较基准
- **不确定性采样变体**:不同不确定性度量的比较
- **被动学习**:传统监督学习作为上限参考
#### 6.2.2 统计检验
- **显著性检验**:t检验、ANOVA等统计方法
- **多次实验平均**:减少随机性的影响
- **交叉验证**:确保结果可靠性
### 6.3 可视化分析
#### 6.3.1 学习曲线可视化
- **性能-样本数曲线**:展示不同方法的效率对比
- **收敛对比图**:不同方法达到相同性能所需的样本数
- **成本效益图**:标注成本与性能提升的关系
#### 6.3.2 样本分布可视化
- **特征空间投影**:展示主动选择样本的分布
- **决策边界可视化**:展示模型学习过程
- **不确定性分布图**:展示模型不确定性的变化
## 七、未来发展方向
### 7.1 算法创新
#### 7.1.1 深度主动学习
- **不确定性估计改进**:更准确的深度模型不确定性量化
- **表示学习结合**:在特征学习阶段融入主动学习
- **自监督预训练**:减少对标注数据的依赖
#### 7.1.2 多任务主动学习
- **知识迁移**:相关任务间的知识共享
- **多目标优化**:平衡多个学习目标
- **终身学习**:持续学习新任务
#### 7.1.3 强化学习结合
- **序列决策**:将样本选择建模为序列决策问题
- **长期回报优化**:考虑长期学习效果
- **探索-利用平衡**:借鉴强化学习的探索策略
### 7.2 应用扩展
#### 7.2.1 新兴领域应用
- **量子机器学习**:量子计算环境下的主动学习
- **边缘计算**:资源受限设备的主动学习
- **联邦学习**:分布式隐私保护场景
#### 7.2.2 跨学科融合
- **认知科学启发**:模拟人类学习过程的主动学习
- **教育学应用**:个性化教育中的内容选择
- **经济学整合**:考虑标注成本的经济模型
### 7.3 系统化工具
#### 7.3.1 开源框架发展
- **标准化接口**:统一的主动学习API
- **模块化设计**:可插拔的查询策略和模型
- **可视化工具**:交互式的主动学习实验平台
#### 7.3.2 自动化系统
- **端到端流水线**:从数据准备到模型部署的全流程
- **自适应参数调整**:自动调整主动学习参数
- **智能标注平台**:集成主动学习的标注系统
#### 7.3.3 可解释性增强
- **样本选择解释**:解释为什么选择特定样本
- **学习过程透明化**:可视化模型学习进展
- **决策依据展示**:展示模型预测的不确定性来源
---
- **总结**:主动学习作为一种高效的机器学习范式,通过智能选择最有价值的样本进行标注,显著降低了数据标注成本。其核心在于查询策略的设计,需要平衡不确定性、多样性和代表性。随着深度学习和大数据的发展,主动学习在理论和应用上都面临着新的机遇和挑战,未来将在自动化、可解释性和跨领域应用方面持续发展。
复制内容
下载markdown文件
在线编辑